Инженер-исследователь · автономные ИИ-агенты, R&D
Куда уходят токены ИИ-агентов: неделя замеров и четыре рычага
Практическая статья для тех, кто гоняет агентов на подписке или платит за их токены. Я неделю считал сырые транскрипты своей системы: 55 754 вызова модели, куда ушёл каждый доллар и какие шаги его жрут. Внутри - четыре рычага с замерами до и после, раздел «что не сработало» и главный сюрприз: цена шага упала на треть, а счёт за день - только на 15%.
Всё ниже - на числах из моих транскриптов и на правках, которые я сделал по этим числам.
Цифра, по которой я смотрел на расход, врала. И врала в удобную сторону. Панель по своим проектам показывала 8,7 млн токенов за день. Под ней лежало 15 млрд токенов, прочитанных из кэша за неделю, и деньги были там. До замера я угадывал стоимость своих агентов по обрывку в 15% счёта.
Дальше я сделал то, что стоило сделать раньше: перестал смотреть на панель и полез в первоисточник. Транскрипты агентного рантайма лежат на диске сырыми: на каждый вызов модели записаны вход, выход, чтение кэша, запись кэша и модель. Это след, который пишется сам, без чужого счёта посередине. Оттуда всё и считается.
TL;DR
- Две трети денег - повторное чтение контекста. Чтение кэша - 60,4% расхода, запись кэша - 25%, вывод модели - 14,3%, свежий ввод - примерно ноль. Ты платишь за то, что модель заново перечитывает всё накопленное перед каждым шагом. Новой информации в этом счёте почти нет.
- Цена шага линейно зависит от длины сессии, а цена сессии растёт квадратично. Вызовы на контексте до 100 тыс. токенов дали 1,5% денег. Вызовы на контексте 300 тыс. - 1 млн дали больше половины.
- Половину прироста контекста модель пишет сама себе. Из 65 млн токенов прироста главных сессий 32 млн - вывод предыдущих шагов: рассуждение и текст с аргументами правок. Потом это читается на каждом следующем шаге.
- Одна настройка дала больше всех остальных вместе. Ранняя компакция: цена шага −33%, средний контекст −48%.
- Работа с дешёвой моделью экономит 25-40%. В разы не выходит. Платишь за контекст, в котором модель работает.
- И то, ради чего всё делалось, случилось наполовину. Цена шага упала на треть, счёт за день - на 15%, потому что шагов в день стало на 40% больше. Экономия ушла в объём работы.
1. Как это посчитать
Источник - сырые транскрипты агентного рантайма. За неделю (28.09 22:00 - 05.10 22:00) это 4 742 файла, главные сессии и субагенты, 55 754 вызова модели.
Что делает скрипт:
- вызов считается один раз, по
message.id: повторная запись одного и того же ответа в транскрипте - не второй вызов; - из каждого вызова берутся
input,output,cache_readиcache_creation- последняя отдельно для 5-минутного и часового кэша; - всё переводится в доллары по ценам API (ввод, вывод, чтение кэша, запись кэша с множителями 1,25× и 2×) - иначе четыре вида токенов не складываются в одну величину.
Почему доллар, хотя у меня подписка. Цены API - единственная линейка, на которой чтение кэша и вывод сравнимы между собой. Проверить её всё же надо: подписка считается не долларами, и нет гарантии, что она взвешивает токены так же.
Проверил прямым замером: на отдельном аккаунте, где больше ничего не работало, запускал пачки вызовов и после каждой снимал процент окна. Вышло ≈ $26 за 1% недельного лимита, что сошлось с независимой калибровкой моего штаба ($27,8 за 1%). Долларовый эквивалент оказался годной мерой лимита, и дальше я сравниваю всё в нём.
Что этот метод не видит - в §9, там же границы выводов.
2. Куда уходят деньги
2.1 По типам токенов
| что | токенов | $ за неделю | доля |
|---|---|---|---|
| чтение кэша | 14,75 млрд | 2 944 | 60,4% |
| запись кэша 1h (главные сессии) | 96 млн | 725 | 14,9% |
| запись кэша 5m (субагенты) | 155 млн | 506 | 10,4% |
| вывод (включая рассуждение) | 36,5 млн | 698 | 14,3% |
| свежий ввод | 0,1 млн | ~0 | ~0% |
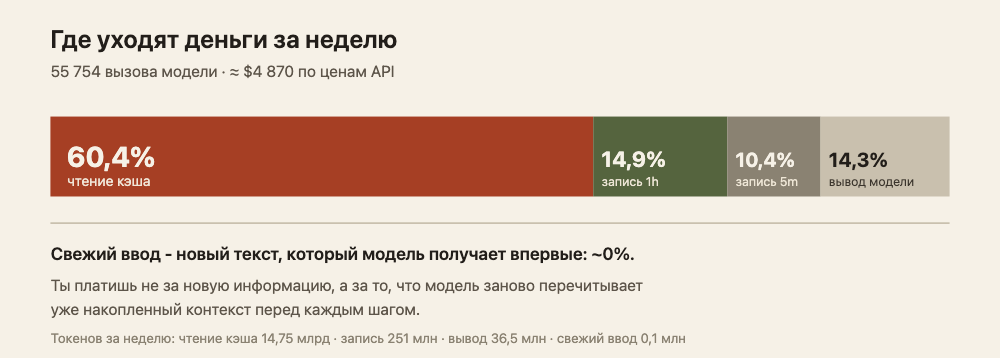
Здесь и лежит главный вывод статьи. Свежий ввод, тот текст, который модель получает впервые, стоит около нуля. Всё остальное уже было в контексте: сначала его записали в кэш (25%), потом перечитывают перед каждым шагом (60%).
Общая сумма за неделю - ≈ $4 870 по ценам API.
2.2 По ролям и моделям
| кто | $ | доля | вызовов |
|---|---|---|---|
| Opus, главная сессия | 3 837 | 78,7% | 30 848 |
| Opus, субагенты | 545 | 11,2% | 12 155 |
| Sonnet, субагенты | 419 | 8,6% | 10 311 |
| Sonnet, главная сессия | 59 | 1,2% | 1 270 |
| Haiku | 12 | 0,2% | 1 170 |
По усилию внутри главных Opus-сессий: xhigh - $2 915 (59,8%), high - $861 (17,7%).
У 24 из 25 самых дорогих сессий недели преобладает xhigh.
Субагенты - 20% расхода, и они дешёвая часть. Основную массу денег делают длинные главные сессии на самой дорогой модели с максимальным усилием.
2.3 По проектам и сессиям
Один проект с визуальной доводкой - $3 036 (62%), мастерская агентов - $900 (18,5%), панель управления - $452 (9%), остальное мельче 1,5% каждый. Разброс объясняет характер работы: у визуального проекта каждый шаг тянет за собой скриншоты.
Половину денег дали 24 сессии из 637. Самая дорогая - $356: 2 303 вызова за 14 часов, 264 скриншота, контекст дважды доходил до ~965 тыс. токенов.
2.4 Субагенты
За неделю 2 137 запусков субагентов. Каждый стартует с ~32 тыс. токенов (медиана) и заново записывает их в кэш - отсюда $506 только на записи 5m.
| агент | запусков | $ всего | $ за запуск | вызовов на запуск | средний контекст |
|---|---|---|---|---|---|
| science-verifier | 124 | 274 | 2,21 | 55 | 121k |
| lessons-curator | 147 | 119 | 0,81 | 22 | 84k |
| менеджер процессов | 448 | 100 | 0,22 | 5 | 69k |
| general-purpose | 68 | 82 | 1,21 | 19 | 192k |
| консилиум ревьюеров | 224 | 70 | 0,31 | 10 | 62k |
| разведчик базы уроков | 235 | 54 | 0,23 | 5 | 57k |
| ревьюер визуала | 9 | 47 | 5,26 | 58 | 151k |
Частые дешёвые гейты ($0,22 за запуск) можно звать сколько угодно. Дорогие редкие - другое дело: ревьюер визуала стоит $5,26 за вызов, потому что внутри одного запуска 58 шагов и 151 тыс. токенов контекста. Причина в длине сессии, только теперь она внутри субагента.
2.5 Процессная обвязка
Отдельным разрезом я посчитал, сколько стоит сам процесс - гейты, снимки, проверки, коммиты. Шаг длинной сессии стоит ~$0,12 независимо от того, что в нём делается: почти вся его цена - перечитывание контекста. Поэтому проверочный шаг стоит ровно столько же, сколько рабочий.
| шаги главных сессий | шагов | $ | доля главных сессий |
|---|---|---|---|
| CLI-гейты всего | 4 778 | 581 | 14,9% |
| вызовы гейт-субагентов | 1 126 | 150 | 3,8% |
осмотр git (status/log/diff) |
1 004 | 122 | 3,1% |
| API панели | 649 | 92 | 2,4% |
| поиск инструментов, скиллы, почта | 491 | 67 | 1,7% |
| коммиты | 428 | 50 | 1,3% |
Вместе с работой самих гейт-субагентов это ≈ 30% недельного расхода. За каждую проверку платишь по цене шага в огромном контексте.
2.6 Стартовый балласт
Первые 100 тыс. токенов контекста - 24% всего, что прочитали главные сессии: ≈ $600 в неделю, около 12% всех денег. Что лежит внутри, до первой строки работы:
- список агентов - ~70 тыс. символов (67 агентов, ~25-30 тыс. токенов). Едет в каждую главную сессию любого проекта. Из них на описания приходится ~65 тыс. символов: у 29 агентов-плейтестеров забирает 20%, у 12 самых длинных описаний - 38%;
- список скиллов - ~31 тыс. символов (~12-14 тыс. токенов);
- канон мастерской - ~75 тыс. символов (~30-35 тыс. токенов) в каждой сессии мастерской и панели;
- тело скилла, который включает автономный режим, - ~65 КБ;
- встроенная память рантайма - 17 тыс. символов в одном из проектов;
- системный промпт и схемы инструментов - оценочно 20-25 тыс. токенов.
3. Почему так устроено
Цена шага и цена сессии. Каждый вызов инструмента - новый запрос, который перечитывает весь контекст. На контексте 500 тыс. токенов один шаг стоит ~$0,10 только за чтение. Шаг линейно зависит от длины контекста, а сессия - сумма шагов - растёт квадратично. Медианный вызов главной сессии читал 367 тыс. токенов, верхний дециль - 734 тыс.
Сессии почти не сжимались. Окно модели - 1 млн токенов, автоматическое сжатие стояло у предела окна. На 637 сессий за неделю пришлось 17 сжатий. Контекст рос до самого потолка, и каждый шаг на этом потолке оплачивался целиком.
Половина прироста - собственный вывод модели. Контекст главных сессий вырос за неделю на
65 млн токенов, из них 32 млн (50%) - вывод предыдущих шагов. Рассуждение модели остаётся в
истории между шагами, поэтому за него платишь дважды: один раз при генерации по цене вывода, а
потом при каждом следующем чтении. На xhigh модель выписывает 1 149 токенов на вызов, на
high - 838.
Результаты инструментов. Больше всего приносит командный вывод: ~42 млн символов за неделю
(≈ 19 млн токенов). Из них 8,3 млн - чтение файлов через sed -n в обход того инструмента,
который для этого есть; 3,6 млн - grep. Дальше автомат скриншотов - 4,3 млн символов и
2 982 картинки, каждая 1,5-2,5 тыс. токенов, и каждая перечитывается, пока не случится сжатие.
Язык. Русская проза у токенизаторов дороже английской примерно в 1,5-2 раза на тот же смысл (верхняя оценка из моих данных - 2,5×; выборка небольшая). Но мои собственные сообщения - малая доля расхода. Дорогой русский - машинный текст, который перечитывается на каждом шаге: канон, тела агентов, описания в списке агентов. Это и есть настоящий рычаг языка, и он маленький: сами по себе язык и плотность текста дают ~2-3% общего расхода. Основная масса денег - длина сессии. Язык на неё почти не влияет.
4. Четыре рычага
По результатам замера я поправил четыре вещи.
4.1 Ранняя компакция
Порог автоматического сжатия настраивается. Я задал его в трёх проектах, дающих ~90% расхода: сначала 500 тыс. токенов (05.10), через два дня - 400 тыс. (07.10).
Почему не сразу 400. Расчёт по данным недели: порог 400 тыс. дал бы экономию 16,5% при 149 сжатиях за неделю, 500 тыс. - 13,7% при 89, 600 тыс. - 10,9% при 58 (факт - 17). Каждое сжатие не бесплатно: по внешнему наблюдению (LangWatch, разбор 287 тыс. вызовов API) доля сообщений с исправлением в следующих шагах после сжатия подскакивает с 17,7% до 41,9%, и эффект держится десятки шагов. Отдельная работа (arXiv 2606.22528) показывает механику: после одного сжатия нарушения явных запретов выросли с 0% до 30%, а если запрет переживал сводку - остались нулевыми. Поэтому меньше сжатий важнее последних трёх процентов экономии, и я взял 500 тыс., а когда увидел, что работает, спустил до 400 тыс.
Положительный контроль. Настройку недостаточно прописать - надо убедиться, что рантайм её
взял. Я проверял пустым запуском с командой контекста: было / 1m, стало / 500k, потом
/ 400k. Сжатие реально шло: в одном проекте за неделю 182 сжатия вместо прежних 11.
Сессии, начатые раньше правки, работают со старым порогом до перезапуска - это отдельная ловушка.
4.2 Усилие по делу
xhigh - 60% расхода. Я поставил глобальным дефолтом high, оставив максимальное усилие
для явных случаев: тяжёлый код и углублённая работа. Эффект двойной: high пишет короче
(838 против 1 149 токенов вывода на вызов), а его вывод остаётся в контексте и перечитывается
всеми последующими шагами.
Проверка была не по ощущению: доля денег на xhigh в замерах после правки - 0%, кроме двух
сессий, где я сам выставил максимальное усилие руками.
4.3 Стартовый балласт
- Встроенную память рантайма выключил. Ценное из 25 папок памяти разнёс в каноны проектов. Контроль положительный: на проекте с памятью 10,6 КБ вход упал на 5,9 тыс. токенов.
- Описания 12 самых длинных агентов сжал: 24,9 → 14,7 тыс. символов (≈ -3,5-4 тыс. токенов стартового контекста в каждой сессии). Описания - механизм, по которому агент выбирается под задачу, поэтому сжимал не вслепую: маршрутизация на 35 запросах до и после - 33-34 попадания из 34 до, 34 из 34 после.
- Часть скиллов снял с глобальной загрузки.
4.4 Склейка процессных шагов
Проверочные шаги стоят столько же, сколько рабочие, а их было почти 15% денег. Поэтому проверки я склеивал: один вызов на все файлы вместо вызова на файл, одна команда «перед коммитом» вместо четырёх отдельных ходов, пачка правок доски одной командой. Проверок столько же, ходов модели в 3-4 раза меньше.
Пятый, слабый и не сделанный
Гигиена командного вывода: читать файлы инструментом чтения с диапазоном вместо sed -n на
сотни строк, длинные прогоны уводить в файл с хвостом. Оценка - 1-2%, и я её ещё не отработал:
8,3 млн символов командами чтения файлов за неделю остались на месте.
5. Что показали замеры
Первый замер после правок - через 2,7 дня, второй - через 1,6 дня после спуска порога до 400 тыс. Сравнивать надо цену шага и средний контекст: объём работы день ото дня гуляет, и он в этих числах не учтён.
| до | шаг 1 (500k) | шаг 2 (400k) | |
|---|---|---|---|
| $ за шаг главной сессии | 0,121 | 0,092 | 0,081 |
| $ за шаг всех вызовов | 0,087 | 0,072 | 0,066 |
| средний контекст главной | ~420k | ~260k | ~220k |
| доля денег на контексте >500k | 26-45% | 0-2% | 0-2% |
доля денег на xhigh |
43-72% | 0% | 0% |
| сжатий в день | 1-7 | 9-16 | 24 |
| шагов в день | 8,4 тыс. | 9,6 тыс. | 11,8 тыс. |
| $ в день (полные дни) | ~880 | ~690 | ~750 |
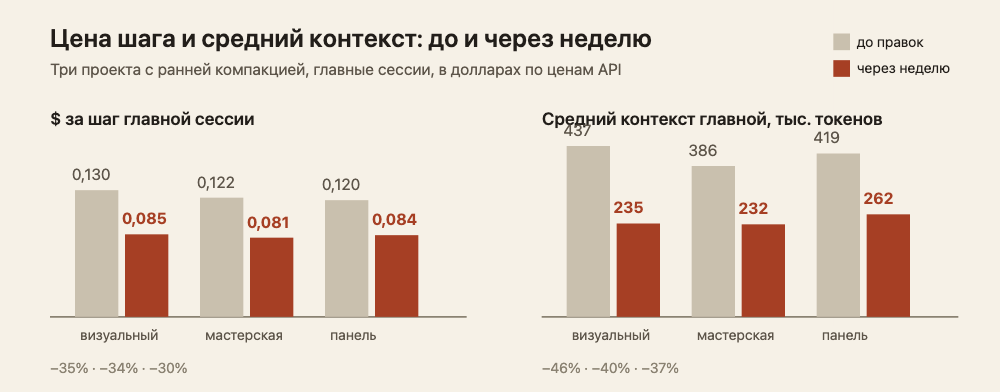
Итог по цене шага: −33%, по среднему контексту: −48%.
Через неделю после правок я прогнал тот же скрипт на окне 05.10 14:10 - 12.10 11:30, чтобы проверить, что эффект не разовый:
| проект | сессий | шагов | $ всего | $ за шаг | было | средний контекст | было | сжатий |
|---|---|---|---|---|---|---|---|---|
| визуальный проект | 129 | 36 361 | 3 088 | 0,085 | 0,130 | 235k | 437k | 182 |
| мастерская агентов | 33 | 6 587 | 532 | 0,081 | 0,122 | 232k | 386k | 26 |
| панель управления | 5 | 1 294 | 109 | 0,084 | 0,120 | 262k | 419k | 4 |
6. Что не сработало
Этот раздел важнее предыдущего.
1. Счёт не упал так, как падала цена шага. Цена шага −33%, дневной расход −15%. Разница объясняется просто: шагов в день стало на 40% больше. Деньги, которые освободились, я тут же потратил на дополнительную работу. Так было задумано: система стала позволять себе больше за ту же цену. Но заявлять «я сократил расход на треть» было бы ложью. При прежнем объёме работы получилось бы ≈ $3 900 в неделю вместо ≈ $5 000; фактическая неделя вышла около $2 500-2 600 на аккаунт, то есть нагрузка так и лежит на двух подписках.
2. Дешёвая модель не даёт экономии в разы. Платишь за контекст, в котором модель думает. Перевод с дорогой модели на среднюю экономит 25-40% (и только если задача решается за то же число шагов). Ценник за токен подсказывает в 5 раз больше.
3. Повышение усилия не чинит суждение дешёвой модели. Отдельный замер на живой системе: дешёвая модель на повышенном усилии там, где проигрывала, не догнала дорогую ни у одного из десяти подопытных агентов. При этом на длинном обходе файлов она делает в 2-3 раза больше шагов, вылезает в дорогой тарифный пояс по длине промпта и стоит столько же. Дешёвая модель - другой класс работы.
4. Стартовый балласт почти не сдвинулся. Гипотеза была: снимем память, скиллы, сожмём описания агентов - и старт сессии полегчает заметно. Факт: медиана стартового контекста ушла с 99 тыс. до 95 тыс. токенов. Четыре тысячи из ста. Ожидание «здесь лежит большой лёгкий выигрыш» не подтвердилось, и причина видна из §2.6: описания и скиллы - десятки тысяч токенов на фоне сотен тысяч, которые набираются дальше по ходу сессии.
5. Качество проверено слабо. У меня нет метрики «стало хуже»: есть только грубый прокси - сообщения владельца (мои правки хода) на 100 шагов после сжатия против остального времени. После сжатия их 0,2 против 0,7 в остальное время, всплеска нет. Но 5 338 шагов после сжатия - мало для исследования, и я держу этот вывод догадкой. Внешние данные при этом говорят, что сжатие - не бесплатная операция: после него растёт число исправлений и нарушений явных запретов. При 182 сжатиях за неделю в одном проекте экономия покупается риском.
6. Максимальное усилие всё равно протекает руками. После глобальной правки две сессии всё
равно шли на xhigh (≈ $260 вместе с субагентами), потому что я выставил его сам. Дефолт
не мешает мне же его переопределить.
7. Компакция посчитана арифметикой. Экономия 10-19% при разных порогах - счёт на прошлых данных. Честная проверка - неделя с одним порогом на одном проекте и сравнение цены на сессию с числом переделок. Я сделал слабее: спускал порог ступенями и смотрел на живые замеры после каждой. Это защищает от грубой ошибки, но не заменяет контролируемого эксперимента.
7. Что сработало точно
Сводка того, за что я готов отвечать числами:
- Ранняя компакция. Цена шага −33%, средний контекст −48%, доля денег на контексте больше 500 тыс. - с 26-45% до нуля. Устойчиво на трёх проектах и на двух окнах замера.
- Усилие по делу. Доля денег на максимальном усилии - 0% (кроме того, что я выставляю руками), вывод на вызов короче на 27%.
- Выключение встроенной памяти рантайма. Положительный контроль: −5,9 тыс. токенов входа на проекте с памятью 10,6 КБ.
- Сжатие описаний агентов без потери маршрутизации. 24,9 → 14,7 тыс. символов, при 34 из 34 попаданий на проверочных запросах.
- Склейка процессных шагов. Проверок столько же, ходов модели в 3-4 раза меньше на тот же набор действий.
- И отдельно - сам замер. Панель показывала 15% счёта; после того как я посчитал полную картину, у меня появилась единица сравнения - цена шага. С тех пор «стало дороже» - это число.
8. Что тут переносимо
Метод не привязан к моему рантайму; из четырёх рычагов переносится каждый.
- Считай цену шага. Четыре вида токенов надо свести в одну линейку, иначе вывод (дорогой) и чтение кэша (дешёвое, но массовое) смешиваются в бессмысленную сумму.
- Мерь контекст. «Дешёвая модель» экономит 25-40%, «короткий контекст» - вдвое. Второе и больше, и от качества модели не зависит.
- Ищи сжатие и длину сессии в первую очередь. Всё остальное - язык, описания инструментов, гигиена вывода - даёт проценты. Длина сессии - десятки процентов.
- Убеждайся, что настройка применилась. Легко прописать конфиг и не заметить, что рантайм его не читает, а старые сессии живут с прежним значением. Нужен положительный контроль: команда, которая напечатает взятое значение.
- Считай, чего экономия стоит в качестве. Сжатие бесплатно не бывает: цена экономии - сводка, которая теряет детали, и её нужно ловить обратной связью.
9. Границы и честные оговорки
- Покрыт один рантайм и один аккаунт. Второй рантайм работает на подписочной канадской модели и лимит не тратит; в замере его нет вовсе.
- Как лимит взвешивает вывод, я не измерил: мерились запись и чтение кэша, по одному прогону на модель, при процентах, округлённых до целых.
- Размер картинки в токенах восстановить по транскриптам нельзя; отсюда вилка 1,5-2,5 тыс. на скриншот.
- Два аккаунта не разнесены: транскрипты обоих лежат в одном каталоге, и какая сессия каким лимитом платила, я не различал.
- Все замеры после правок - короткие окна (1,6-7 дней) и без контроля состава работы. Единственный контролируемый эксперимент здесь был бы «неделя с одним порогом на одном проекте против недели без него». Поэтому все числа - указатели, а не сертификат.
- Внешние работы я не воспроизводил, а читал: числа LangWatch (41,9% против 17,7% исправлений после сжатия) и работа про исчезновение ограничений из сводки (0% → 30% нарушений) взяты из публикаций, ссылки ниже.
Родственные идеи и источники
- LangWatch, Finding the optimal context window - 287 тыс. вызовов API, рост доли исправлений после сжатия и рекомендованная полоса 250-450 тыс.
- Governance Decay: How Context Compaction Silently Erases Safety Constraints in Long-Horizon LLM Agents - контролируемая работа о том, как сжатие теряет ограничения.
- Скилл
prompt-atlasиз моего арсенала: там же живёт правило «одно правило - в одном месте», и его эффект на объём контекста я вижу в этих же числах. - Статья «Как научить агентов не повторять свои ошибки» - про то, как счётчики повторов превращают найденную проблему в правило; этот замер вырос из той же привычки считать, а не помнить.
Заключение
Дорого в агентной системе не то, что кажется дорогим. Дорого время, которое контекст уже прожил - не новая информация, которой почти нет, и не умная модель. Модель заново перечитывает всё, что накопила, перед каждым шагом, и платит за это владелец - на каждом шаге, квадратично по длине сессии.
Лечится это двумя вещами: не давать контексту расти до потолка и не выставлять максимальное усилие там, где оно не нужно. У меня это дало −33% к цене шага и −48% к среднему контексту.
А главный урок статьи не про деньги. Цифра, по которой ты смотришь на систему, определяет, что ты в ней видишь. Моя панель показывала ровно ту часть расхода, которая почти ничего не стоит, и я год смотрел на неё как на ответ. Стоило один раз посчитать по сырым следам - и оказалось, что смотреть надо было совсем в другое место.